概率敏感性分析与微观模拟
概率敏感性分析的方法是对参数取值集合进行抽样,并针对每个集合重新计算模型的期望值。成本效果模型上的概率敏感性分析一节介绍的是队列模型的 PSA。对于患者模拟模型,PSA 的输出完全相同。
这类概率敏感性分析的理论背景在其他文献中有详细讨论,例如发表在 Journal of the Society for Medical Decision Making 上的论文,包括:
"Monte Carlo Probabilistic Sensitivity Analysis for Patient Level Simulation Models," Anthony O'Hagan, et al, Health Economics, 16:1009–1023 (2007).
"Representing First- and Second-order Uncertainties by Monte Carlo Simulation for Groups of Patients," Elkan Halpern, Milton Weinstein, Maria Hunink, G Scott Gazelle, Med Decision Making 20:314-322 (2000).
建议您研读这些文献以及该主题的其他出版物。
使用微观模拟执行敏感性分析
请参考医疗健康(Health Care)教程中的示例模型 MicrosimulationCancerModel - Distributions.trex。
要借助 PSA 得到有意义的结果,我们需要用分布来表示希望考察其不确定性的某些模型参数。在本模型中,要考察的参数为 cLocal2、pLocalToDead 和 cAE。下图显示了用来表示各参数不确定性的所选分布。
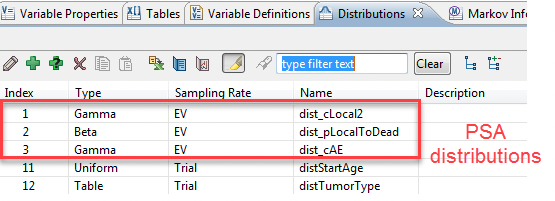
我们已将参数改为希望用于 PSA 的相应分布(通过变量视图(Variables View)完成),即:
cLocal2 = dist_cLocal2
pLocalToDead = dist_pLocalToDead
cAE = dist_cAE
如果只对模型运行常规微观模拟,PSA/EV 分布不会被抽样,分析中使用的是它们的平均值。当我们运行 PSA 加微观模拟时,这些分布才会被抽样。
对微观模拟模型执行概率敏感性分析的步骤如下:
选择根节点。
从菜单中选择 Analysis > Monte Carlo Simulation > Sampling + Trials。或者
使用工具栏,在分析视角(Analyze perspective)中选择双骰子图标。
在蒙特卡洛模拟(Monte Carlo Simulation)对话框中:
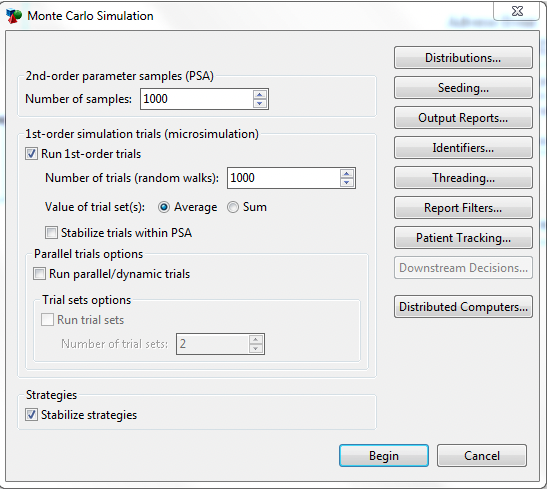
输入二阶参数抽样次数 1,000。即 1,000 个 PSA 样本。
勾选"运行一阶试验(Run 1st order trials)"复选框,并输入试验次数 1,000。即 1,000 次试验。该数目应与基准情形(base case)所需的数目相同。
勾选"在 PSA 中稳定试验(Stabilize trials within PSA)"复选框,以确保这 1,000 次试验的稳定性。勾选该框意味着任何变异都来自样本,而不是来自试验组。
单击 Begin。
重要提示: 要获得稳定、准确的结果,所需样本数与试验次数在很大程度上取决于模型的复杂程度。关于如何确定支持您的分析目标所需的样本数(外循环 = N)与试验次数(内层微观模拟循环 = n),可参阅:
- "Monte Carlo Probabilistic Sensitivity Analysis for Patient Level Simulation Models," Anthony O'Hagan, et al, Health Economics, 16:1009–1023 (2007).
"在敏感性分析中稳定试验(Stabilize trials within Sensitivity analysis)"复选框会自动勾选。这样可确保在模型中运行的患者使用相同的随机数序列。
解读微观模拟模型中的概率敏感性分析
首先,让我们理解运行 PSA 与微观模拟之后到底做了什么:
模型对每个分布进行抽样,每个期望值的重抽样次数用于生成一个样本集,该样本集定义了此次模型计算所用的参数。
模型针对该参数集运行微观模拟。
每个试验进入模型,并从模型中的分布获得特征,这些分布按试验重新抽样。
该试验随后以随机游走(random walk)的方式在模型中推进。
对其余所有试验重复步骤 i 和 ii。
汇总全部 1,000 次试验完成后的最终结果,反映该组参数下的模型计算。
重复步骤 1 和步骤 2,直到所有样本全部完成(本次运行中为 1,000 个)。
输出将以蒙特卡洛仪表板(Monte Carlo Dashboard)的形式呈现。
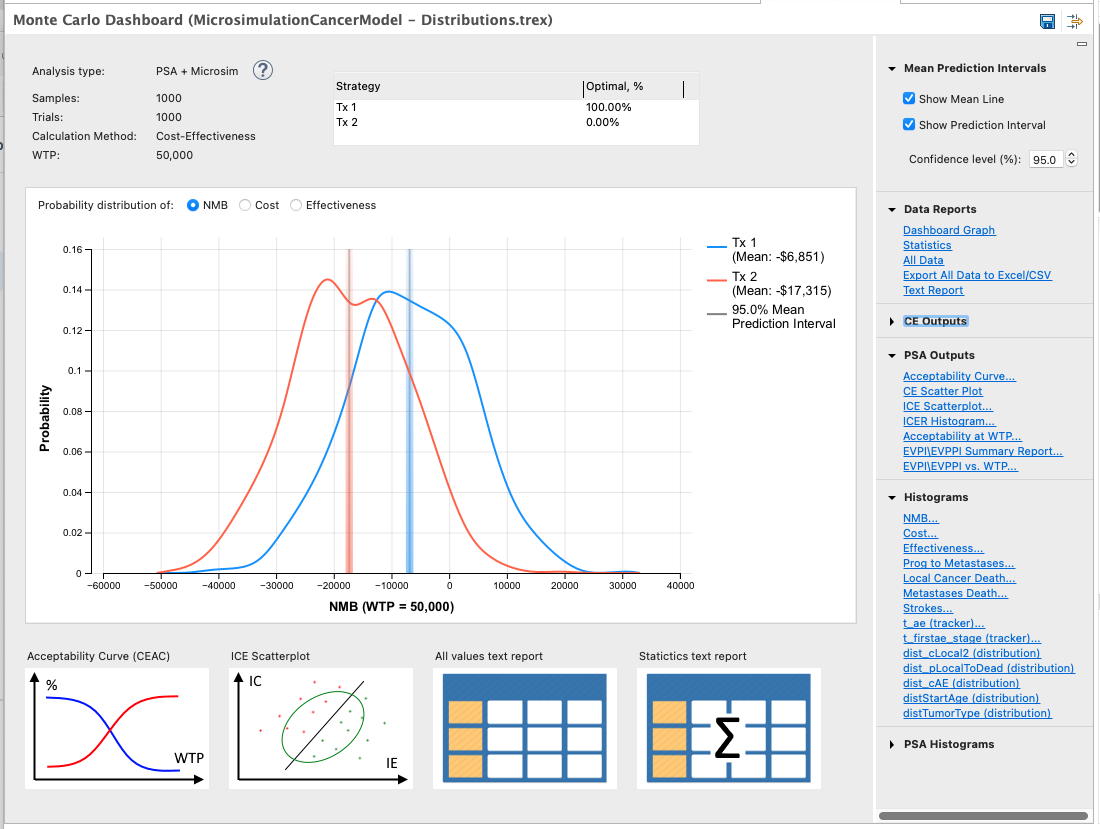
模拟的输出将报告所有微观模拟期望值的汇总结果。要进一步查看细节,请打开统计文本报告(Statistics text report)。统计值的计算方式如下:
每次模型重算(由一组试验构成的微观模拟)都会被平均,从而得到反映所有模型重算的整体平均值。这不是分析的主要关注点,因为我们更关心各次单独计算中发生了什么,而不是总体汇总。
生成的输出包含用于解读结果的 PSA 输出。
如果在仪表板右侧的数据报告(Data Report)部分下选择"全部数据(All Data)",TreeAge Pro 会在每一行显示一次微观模拟的结果。每个迭代(即每个样本)都会基于该迭代的试验组,报告收益值、追踪器和分布样本的平均值。
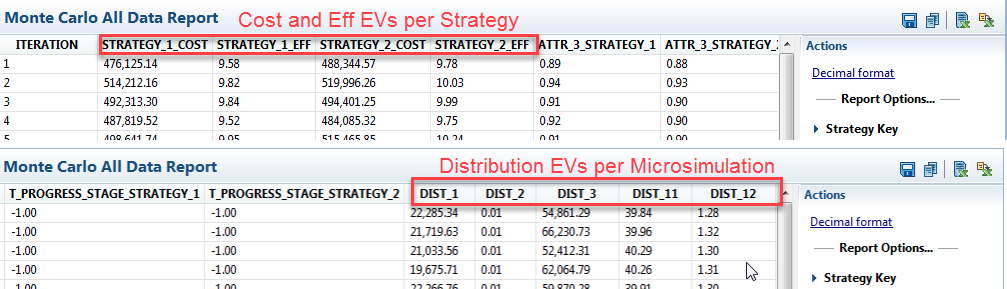
它给出的是一系列平均值,每个平均值都通过对多次试验结果求平均来模拟一次期望值计算。
本质上,一组试验的平均值就是在估计该模型的期望值(EV)。在概率敏感性分析(PSA)的语境下,这一 EV 估计值的用法与成本效果模型上的概率敏感性分析一节中所述 PSA 的 EV 计算相同。这些 PSA 输出也相同,区别只在于每次模型重算所用的是微观模拟。
对于二维模拟(先对分布抽样,再针对每组样本值运行微观模拟试验),所报告的追踪器数值是针对某一组参数样本所运行的每组试验的平均值。