拉丁超立方抽样
拉丁超立方抽样(Latin Hypercube Sampling,LHS)是一种统计方法,用于从多维分布中生成近似随机的参数值样本。在 TreeAge Pro 中,我们将该方法应用于所有共同代表多维参数空间的抽样分布。
默认情况下,TreeAge Pro 从每个分布独立抽样,这通常也是合适的。但是,如果分布数量很多和/或分析时间很长,拉丁超立方抽样可以用更少的 PSA 模型计算生成一组能够代表整体参数集的样本。如果您的 PSA 分析耗时很长,而您希望尝试用更少的迭代运行,可以选择使用此选项。
拉丁超立方抽样如何工作?
拉丁超立方抽样(LHS)将分布参数空间划分为多维的“超立方体(hypercubes)”,并生成样本,使超立方体的每个维度只被使用一次。这可避免从任一分布中抽到非常相似的样本。理论上,LHS 能用更少的实际样本集生成代表整体参数空间的样本。
为进一步理解这一概念,我们来看示例模型 Latin Hypercube Sampling.trex 并运行一些分析。第一个策略对两个均匀分布抽样,这两个分布只返回 1 到 8 之间的整数。将这些分布限制为整数,可以清楚地看出使用 LHS 时每个抽样值都不会重复。
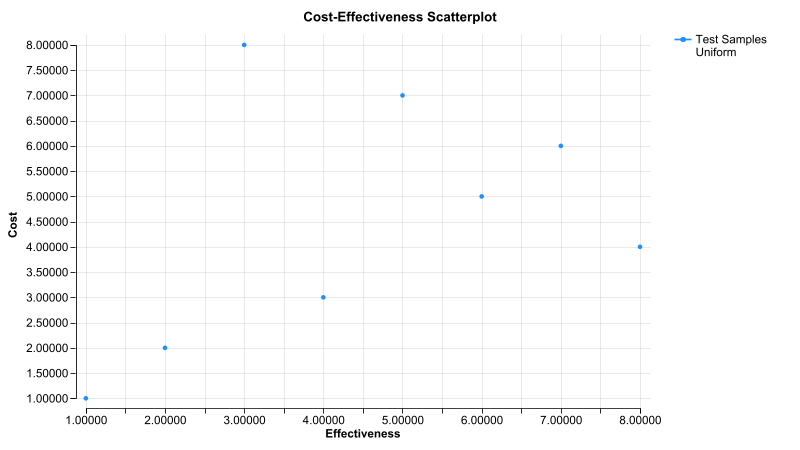
如果我们在不使用 LHS 的情况下对第一个策略运行 8 次迭代的 PSA,各分布将独立抽样。下面的成本效果散点图展示了这些样本,其中一个分布对应“成本(cost)”y 轴,另一个分布对应“效果(effectiveness)”x 轴。

请注意,每个分布都有若干数值被抽到不止一次。例如在 x 轴上,分布 Uniform_X 生成了 4 次数值 3。Uniform_Y 分布也存在重复的抽样值。在本分析中,由于每个分布只有 8 个不同的可能取值,重复样本尤为明显。
拉丁超立方抽样会限制抽样,避免在整个超立方体内重复抽取已经抽过的样本。现在我们通过树偏好设置(Tree Preferences)> 蒙特卡洛选项(Monte Carlo Options)> 分布抽样(Distribution Sampling)启用拉丁超立方抽样,运行同样的分析,如下图所示。

启用 LHS 后运行同样的分析和图形,由于避免了使用过的样本,我们从每个分布得到的都是不重复的样本。
LHS 用总共 8 个样本就更好地代表了完整的参数空间,而未使用 LHS 时显然无法做到这一点。
上述示例是 LHS 的一个极端例子,因为分析中只有 8 个样本,而每个分布也只有 8 个可能取值。我们再来看一个更一般的例子,使用包含两个正态分布的第二个策略。这些分析将分别在使用和不使用 LHS 抽样的情况下运行 100 个样本。
请注意,正态分布是连续的,因此每个分布的总参数空间会根据抽取的样本数量划分为 100 个区间。在多维情况下,任一分布的两个样本都不会抽自同一区间。
不使用 LHS 时,您会看到数值在纵向和横向上都出现一定程度的聚集。

使用 LHS 后,聚集现象减少,因为图中每个抽样值“超立方体”在纵向和横向上都不允许重复取值。请注意,当样本落在连续区间内时这一点不太明显,因为立方体的维度是数值区间。

请注意,为便于可视化,我们只以 2 个维度呈现这些结果,但超立方体的维度数取决于所抽样的分布数量,可以是 N 维的。
通常,LHS 抽样会按每个分布的原生形状进行应用。“使用均匀形状(use uniform shape)”选项会在 95% 置信区间内均匀分配数值,而不遵循分布自身的形状(例如正态分布的样本往往集中在均值附近)。