使用 Python 进行周期中处理
本章大部分内容所用的示例,重点在于使用全局追踪器和停止节点来控制对有限治疗资源的访问。然而,这种方法的局限在于:资源是按试验编号顺序分配给试验的,不考虑优先级和/或等待时间。
如果需要更复杂的规则来控制有限资源的分配,您可以借助在周期中期由 Stop 节点(Stop node)运行的 Python 脚本,把资源分配给特定的试验(trial)。我们先使用 Python 脚本获得与前一模型完全相同的结果,区别在于:由 Python 为在 Stop 节点之后获得资源的试验设置追踪器(tracker)。
打开 Healthcare 教程示例树 Parallel Trials - Queue - Python.trex,其结构与全局追踪器(Global Tracker)模型相同。该模型在试验进展方面完全一致,并且正如我们将要展示的,产生相同的结果。主要差异如下:
不再使用全局追踪器作为控制资源获取的逻辑。
当试验需要资源时,追踪器 t_resource_needed 被设为 1。
当试验不再需要资源时,追踪器 t_resource_needed 被设为 0。
当试验占用资源时,追踪器 t_resource_held 被设为 1。
当试验释放资源时,追踪器 t_resource_held 被设为 0。
使用关键字 _monte_stop_cycle_eval 可在周期中期执行 Python 脚本 PythonAllocateResources,此时部分试验已完成该周期,而其他试验可能停留在 Stop 节点等待资源。
Python 脚本 PythonAllocateResources 通过把获得资源的试验的 t_resource_needed 设为 2 来分配资源。随后逻辑表达式检查 t_resource_needed = 2,以此分配治疗资源。
下面我们回顾并行试验的处理过程,重点放在脚本上。
试验集开始。
开始周期。
通过特殊关键字 _monte_pre_cycle_eval 运行周期前脚本。
按编号顺序运行本周期内的所有试验,直到每个试验到达终端节点或 Stop 节点。
通过特殊关键字 _monte_stop_cycle_eval 运行停止周期脚本。
为停留在 Stop 节点的每个试验完成该周期,直到它们全部到达终端节点。
通过特殊关键字 _monte_post_cycle_eval 运行周期后脚本。
对所有周期重复步骤 2。
试验集完成。
按试验和按试验集生成报表。
上文步骤 2.1 使用的特殊关键字 _monte_stop_cycle_eval 提供了执行 Python 脚本的机会,用以确定谁获得资源,本示例模型正是如此。除此之外,其余部分与全局追踪器模型相同。
下图显示模型中 Healthy 健康状态的结构。图中看不到 _monte_stop_cycle_eval 的执行过程,但它确实会运行。Stop 节点的各分支使用经 Python 脚本更新后的追踪器值。请注意,第二个 Stop 节点使用相同的逻辑。
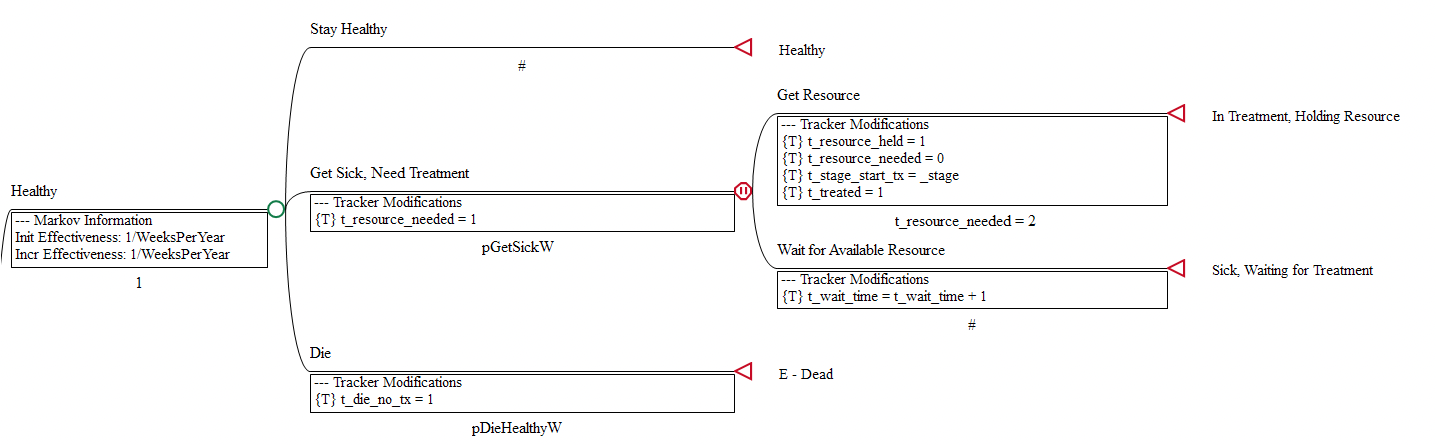
我们可以考察 Stop 节点 "Get Sick, Need Treatment" 及其分支中追踪器的更新情况:
Get Sick, Need Treatment:该试验需要治疗资源,因此需要更新追踪器:
- t_resource_needed= 1
Get Resources:如果该试验获得资源,则 t_resource_needed = 2 的逻辑为真。追踪器更新为:
t_resource_held = 1
t_resource_needed = 0
追踪器的更新在 Python 脚本 PythonAllocateResources 中完成,以满足资源分配的需要,该脚本由特殊关键字 _monte_stop_cycle_eval 执行。请注意下面的根节点变量定义。
- _monte_stop_cycle_eval = DebugContext(6) + DebugWriteForce("Executing _monte_stop_cycle_eval") + PythonAllocateResources(g_resources_available; _stage; _trial_size) + DebugContext(6)
该定义的大部分内容与调试输出有关,但关键部分是调用 Python 函数 PythonAllocateResources。下面介绍 Python 代码的基本功能。
通过函数参数接收当前的可用资源数量,该数量由另一个单独的脚本得出(g_resources_available = PythonGetResourcesAvailable(GlobalTrkGet("gt_TotalResources"); _stage; _trial_size))。
获取对模型中所有并行试验的访问权限。
在仍有可用资源的情况下,循环遍历所有试验。
如果有可用资源且该试验需要资源,则通过将 t_resource_needed 设为 2,把资源分配给该试验。
当所有可用资源分配完毕后,退出循环。
本节并未详细介绍如何设置 Python 脚本,但有些命令对于从 TreeAge Pro 模型中提取细节信息并传入 Python 很有用。这些内容可在 Python 一节以及模型数据访问相关章节中找到。示例模型中的脚本带有大量注释,网上也有大量其他 Python 资源可供使用。
该模型的运行方式与使用全局追踪器的并行试验模型相同。选择微观模拟(Microsimulation),然后输入试验数量并开始运行。请注意,您将从此模型得到相同的结果,因为 Python 函数同样按试验编号顺序分配资源。
使用优先队列的 Python 示例
上文介绍的 Python 脚本模型只是按试验编号顺序分配治疗资源,与全局追踪器模型相同。不过,使用 Python 可以通过编程代码实现更复杂的处理。
Healthcare 教程示例树 Parallel Trials - Priority Queue - Python.trex 增加了额外逻辑,根据从分布中抽样得到的优先级评分来分配资源。Python 代码中的注释说明了具体做法。